Relatório visual
Benchmarks de velocidade e custo do Jev
Como ler estes gráficos
São visualizações da comunidade a partir de intervalos TypeSafe e manchetes de workflow discutidos publicamente. Não são medições de laboratório independentes do jevtypesafe.org. Use-as para entender ordens de magnitude e verifique com seus próprios fixtures pela guia da API.
- Faixas de latência importam mais para gates de roteamento dentro da requisição.
- Preço de entrada + saídas grátis importam mais para scoring de alto volume.
- Multiplicadores de workflow dependem da carga; trate-os como evidência de marketing de faixa alta.
Gráfico de latência
Modelos generativos frontier podem levar de segundos a minutos de ponta a ponta. A faixa System One publicada do Jev é de dezenas a centenas de milissegundos — a diferença entre um gate de agente ágil e uma requisição bloqueada.
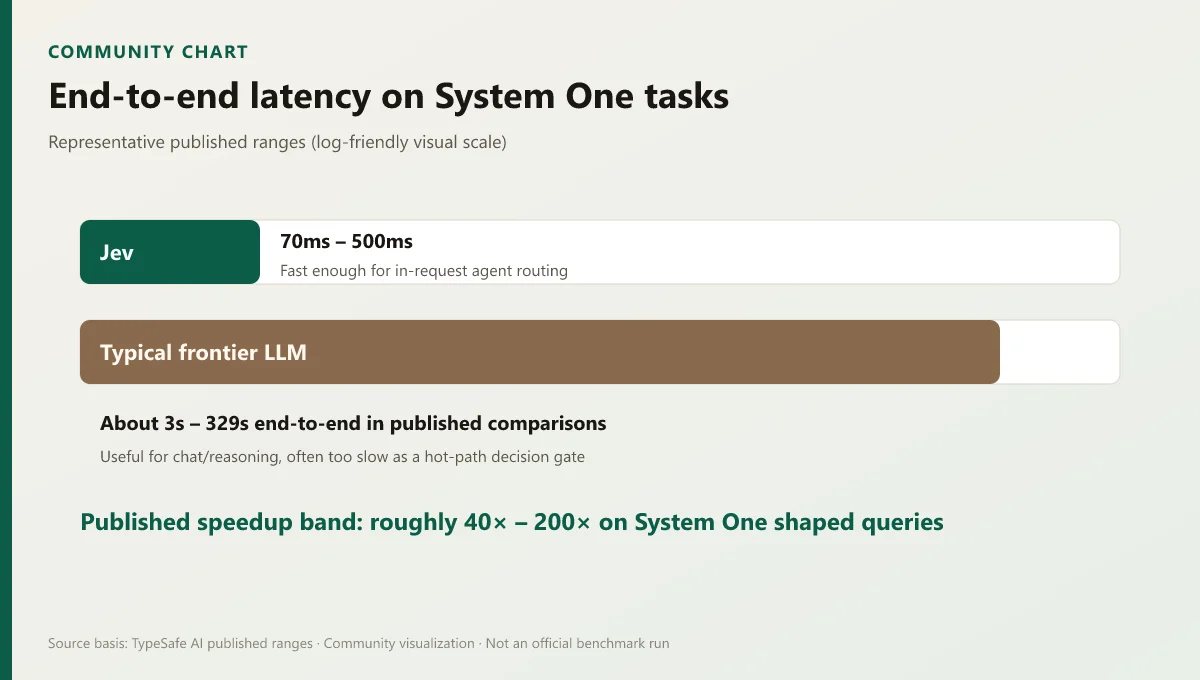
Gráfico de preços
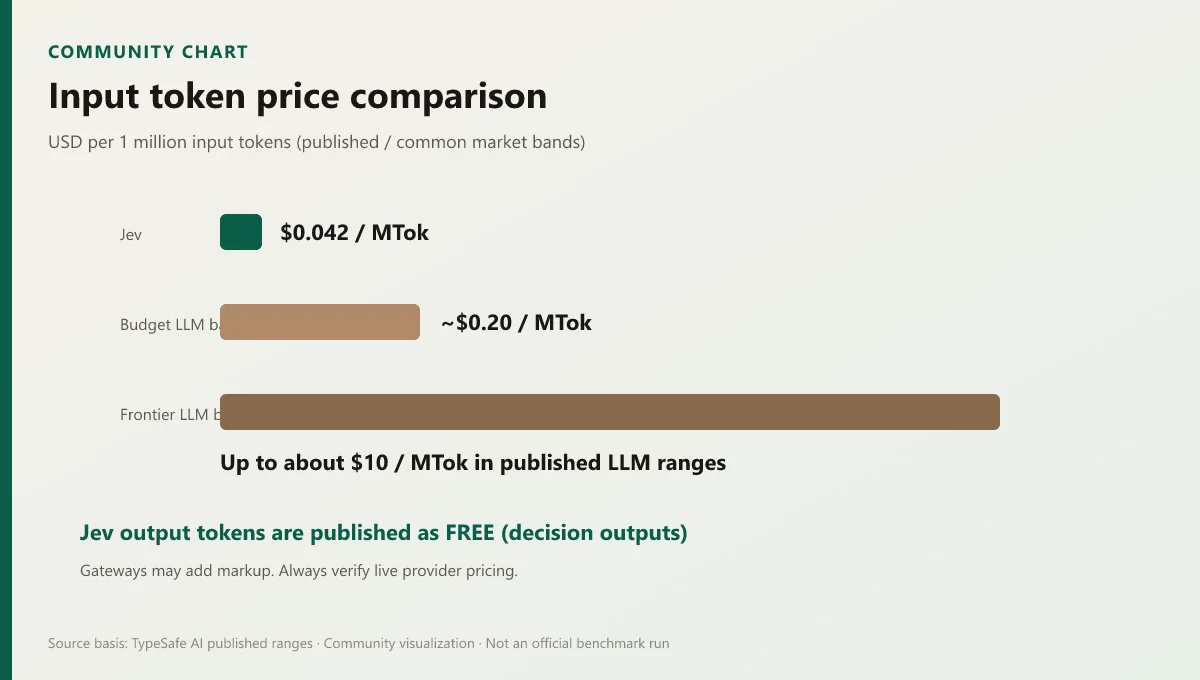
O Jev lista cerca de $0.042 / MTok de entrada e tokens de saída grátis. Faixas LLM comuns começam mais altas na entrada e ainda cobram strings geradas. Gateways podem adicionar markup — confirme tarifas ao vivo antes de orçar.
Manchetes de velocidade e custo do workflow
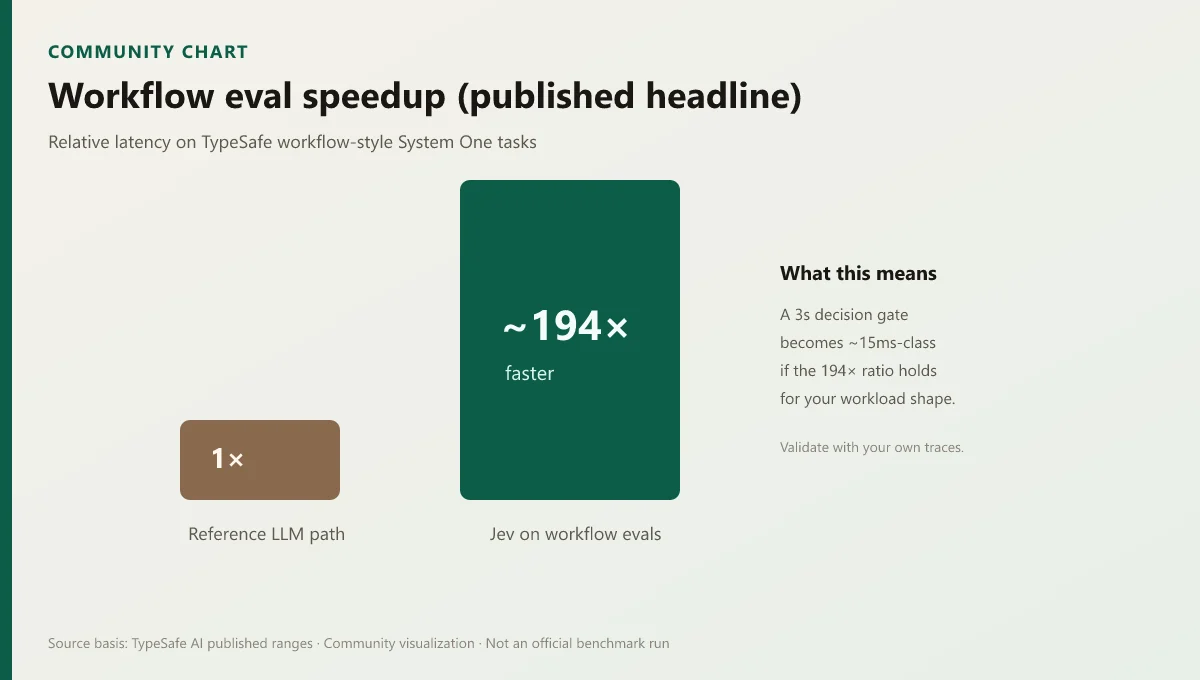
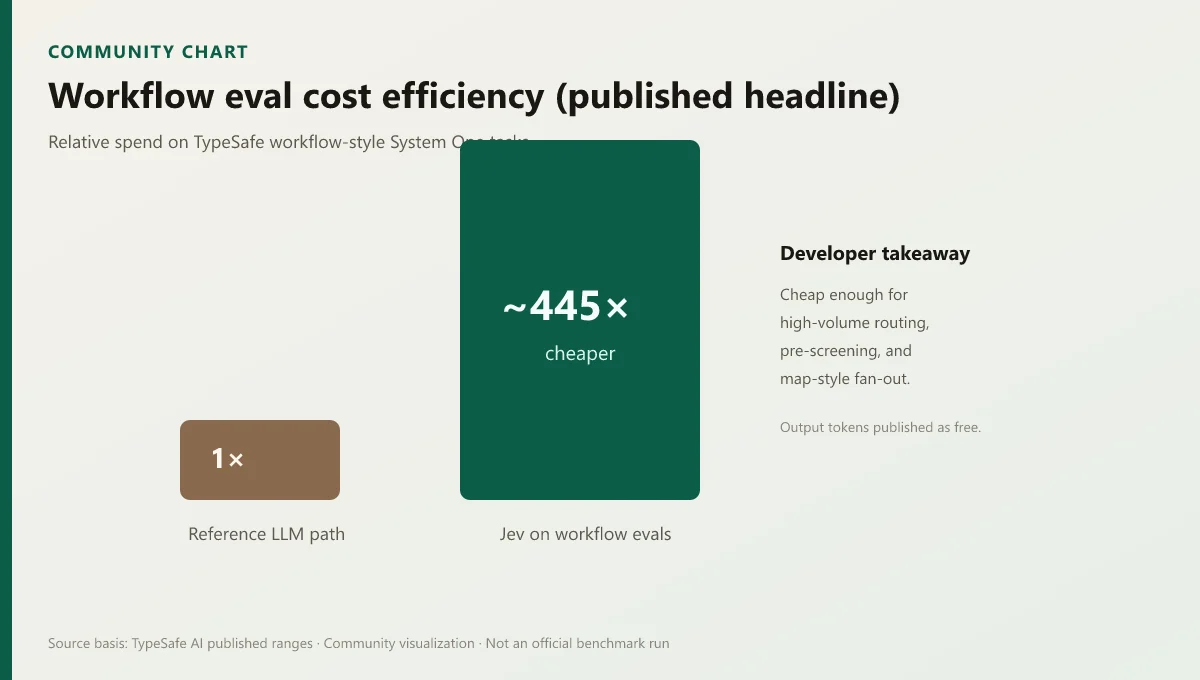
Avaliações no estilo workflow da TypeSafe publicaram números relativos marcantes frente a caminhos LLM de decisão. Os gráficos abaixo tornam essas manchetes escaneáveis para stakeholders que não lerão o eval completo.
Cenários de teste no estilo público
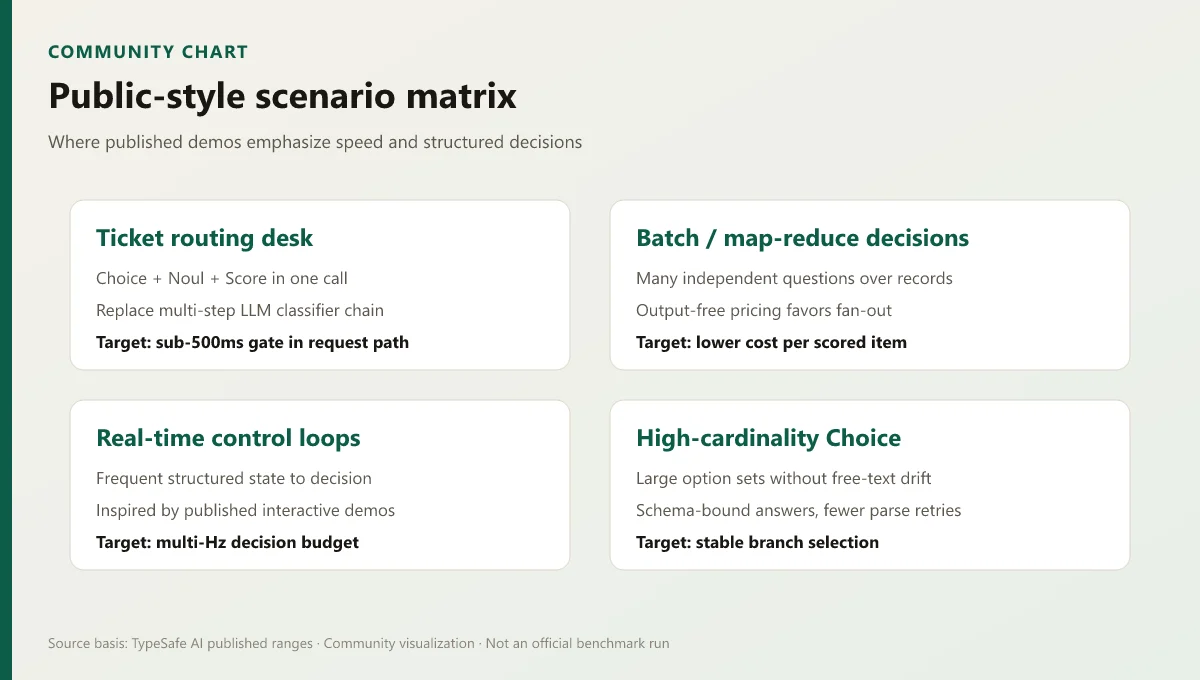
Estes cenários remixam temas de demos públicas e textos de desenvolvedores (mesas de roteamento, decisões em lote, loops interativos, conjuntos grandes de Choice). São templates para fixtures reproduzíveis — não notebooks oficiais copiados.
Mesa de triagem de tickets de suporte
Envie uma mensagem de cliente como state e peça Choice (equipe), Noul (urgente?) e Score (frustração) juntos. Reflete demos públicas de roteamento e substitui uma cadeia classificadora LLM multi-prompt.
Espere decisões subsegundo quando a faixa de latência publicada se mantém.
Pré-filtro antes de raciocínio LLM caro
Use o Jev para filtrar eventos de baixo risco e escalar só casos ambíguos para modelos classe GPT/Claude. É o padrão híbrido que faz os gráficos de custo importarem em produção.
A maior parte do volume fica em chamadas de decisão baratas; o gasto concentra-se em casos difíceis.
Map em lote sobre registros
Pontue ou classifique muitas linhas com o mesmo conjunto de perguntas. Tokens de saída grátis publicados tornam o fan-out especulativo bem menos punitivo do que modelos generativos que cobram respostas longas.
O custo escala sobretudo com o tamanho da entrada, não com respostas verbosas.
Seleção Choice de alta cardinalidade
Passe uma lista grande de opções (equipes, SKUs, choices estilo links wiki). Respostas ligadas ao schema evitam alucinação em texto livre e reduzem retries do parser que inflacionam latência e gasto.
Ganhos de estabilidade se acumulam conforme o número de opções cresce.
Tabela de custo aproximado
Estimativa comunitária aproximada com $0.042 / MTok de entrada e saídas grátis. Assume ~1.000 tokens de entrada por chamada de decisão. Substitua por contagens medidas nos seus traces.
| Decisões mensais | Tokens de entrada aprox. | Gasto estimado de entrada Jev |
|---|---|---|
| 100.000 | 100M | ~$4.20 |
| 1.000.000 | 1B | ~$42 |
| 10.000.000 | 10B | ~$420 |
Compare com classificadores generativos que também cobram saída e muitas vezes precisam de retries após falhas de parse. Para diferenças em nível de recurso, veja Jev vs LLMs tradicionais.
Referência de origem: