Warum ich Jev nicht bei OpenAI bauen konnte — Diogo Almeida
Diogo Almeida · TypeSafe
Decide-API live — jv_live_-Keys, gratis testen
Schnelle, günstige KI-Entscheidungen für Produktion — mit gehosteter Jev-API für Klassifikation, Routing, Scoring und Moderation. Eine strukturierte Entscheidungsschicht für Agenten.
Kein teures LLM für eine einfache Entscheidung. Sofort gehosteter Zugang — gratis starten, dann Prepaid.
Free: 5 runs without signup · 10,000 tokens/month on signup · 3 People Search lookups
Live example
A real support message — several typed decisions in one call.
sample · edit & run for live API
Community explainers
From browser agents to routers and serving — the decision layer plugs in without replacing your generative models.
Führen Sie unten ein echtes Decide aus — inklusive Spielvorschauen ohne Token-Verbrauch — und öffnen Sie danach den vollständigen Jev Playground mit Produktions-Templates (5 kostenlose anonyme Läufe). Wenn Ihnen ein Ergebnis gefällt, übernehmen Sie dasselbe Muster in die API.
Playground
Szenario wählen, Input anpassen, echte API ausführen — Choice, Score und Ja/Nein mit kalibrierten Werten.
Local preview · jev-snake (no API / $0)
Live preview · local heuristic
$0 · no tokensmoves
0
last
—
length
3
Auto-playing with a local heuristic so the homepage stays free. The full game page uses real decide calls (rate-limited demo).
Decision stream
preview · not billed
Jev Snake
* Simulated latency for the preview. Full page = real API round-trip.
Open full Snake demo →Jev AI ist TypeSafes System-One-Entscheidungsmodell: Sie senden State plus typisierte Fragen und erhalten Choice-, Score- oder Noul-Antworten mit kalibrierter Konfidenz — Wahrscheinlichkeiten und Labels, auf die Ihr Code verzweigen kann, keine Chat-Prosa. Diese Website ist ein unabhängiger Drittanbieter-Host (nicht das offizielle TypeSafe-Produkt): Testen Sie den Playground kostenlos und gehen Sie dann mit Prepaid-Keys jv_live_ gegen /api/v1/decide in Produktion.
TypeSafe stellt Jev als System-One-Modell für strukturierte Entscheidungen vor — Labels und Wahrscheinlichkeiten, auf die Software reagieren kann — statt für offene Chat-Generierung.
Vertiefung: System-One-Modell · FAQ · API-Dokumentation
Die drei Primitive von Jev — typisierte Antworten, auf die Ihr Agent-Code verzweigen kann, keine Chat-Strings.
Choice
Wählt ein Label aus einer geschlossenen Menge — routen, erlauben/blockieren, eskalieren.
Score
Geordnete Skala für Dringlichkeit, Risiko oder Qualität, auf der Ihr Code Schwellwerte setzen kann.
Noul
Kalibrierte Wahrscheinlichkeit für Ja/Nein-Gates, ganz ohne Freitext.
Begrenzte Entscheidungen, auf die Ihr Code reagieren kann — kein weiteres Chatfenster.
Support-Triage
Support-Tickets automatisch klassifizieren, priorisieren und weiterleiten.
Agent-Sicherheit
Riskante Aktionen erkennen, bevor ein KI-Agent handelt.
Content-Moderation
Inhalte in erlauben / prüfen / blockieren einteilen.
Lead-Scoring
Eingehende Leads bewerten und wertvolle Interessenten gezielt weiterleiten.
RAG-Relevanz
Entscheiden, ob abgerufene Dokumente relevant sind.
LLM-Routing
Das günstigste Modell wählen, das eine Anfrage bewältigen kann.
Kostenloser anonymer Test (5 Läufe) → Prepaid-Pakete ab $5 (≈ 11.9 Mio. Input-Tokens) → Produktionsguthaben. Abgerechnet wird der Input; Output ist auf diesem Host kostenlos. Retail-Spanne ca. $0.175–$0.42/Mio.
Dies ist eine inoffizielle Community-Ressource. Wir sind nicht mit TypeSafe AI verbunden.
Jev ist das von TypeSafe AI eingeführte System-One-Entscheidungsmodell. Es ist für Agent-Pipelines gedacht, in denen vorhersehbare, konsistente Entscheidungen wichtiger sind als kreativer Text. Das Designprinzip ist einfach: Entscheidungen, nicht Strings.
Dieser inoffizielle Host vergibt sofort jv_live_-Keys und misst Prepaid-Kapazität für /api/v1/decide, /api/v1/batch/decide, gratis /api/v1/gate sowie fertige Produktpfade — Agent-Routing ohne Warten auf die offizielle TypeSafe-Waitlist. Upstream-Keys bleiben auf unseren Servern.
Quellenangabe: Offizieller Ankündigungsbeitrag von TypeSafe AI. System One intro.
Dies ist eine inoffizielle Community-Ressource. Wir sind nicht mit TypeSafe AI verbunden. Sofort ausgestellte Keys im Format jv_live_ sowie Prepaid-Abrechnung, Playground und Batch-Tools. Der Upstream-Modellzugang bleibt auf unseren Servern. Siehe AGB, Datenschutz und FAQ.
Kurze Erklärvideos zu Was ist Jev AI?, wie man es nutztund was man bauen kann. Wiedergabe auf dieser Seite (YouTube-Zugang nötig).
Diogo Almeida · TypeSafe
Greg Isenberg
Hands-on review
The Code Report
Charts basieren auf veröffentlichten TypeSafe-Spannen. Der vollständige Bericht mit Methodik und Szenario-Vorlagen steht auf der Benchmark-Seite.
Sechs visuelle Karten zu wiederkehrenden Punkten in öffentlichen Jev-Intros: Entscheidungen statt Chat-Text, smartes If-Routing, Choice / Score / Noul, parallele Fragen, kalibrierte Konfidenz und schema-sichere Ausgaben.
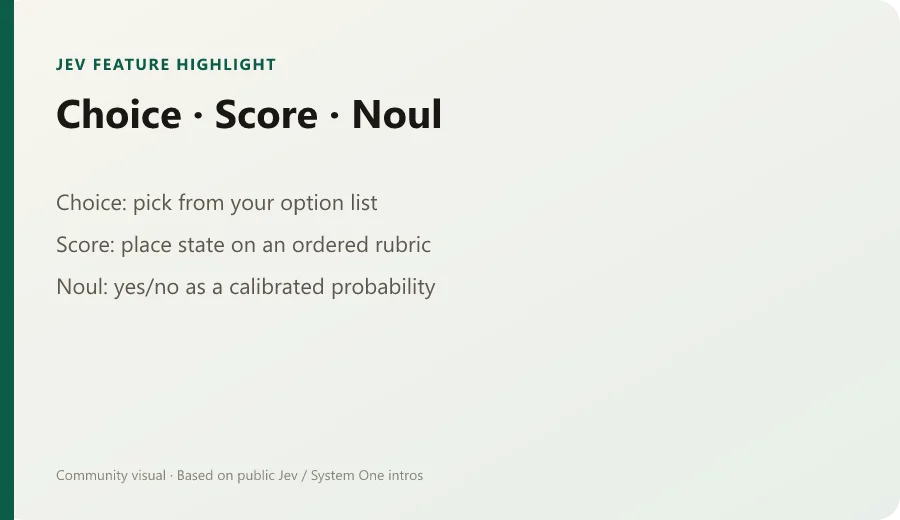
Die Bezeichnungen System One / System Two stammen aus der Verhaltenspsychologie. In der Agent-Engineering-Praxis entsprechen sie zwei verschiedenen Aufgaben in einer Pipeline. Kurzdefinitionen im Glossar.
Produktions-Stacks wählen selten nur eines. Meist sitzt Jev am Entscheidungsrand; ein generatives Modell wird nur gerufen, wenn Prosa, Tool-Planung oder tieferes Reasoning nötig sind. Lesen Sie die Vergleichsseite für einen Feature-für-Feature-Vergleich.
Demo → API kopieren → Registrierung → Prepaid-Key. 15 Use-Case-Guides und ein Live-Playground stehen bereit.
People SearchTutorialBeispieleTypeScriptPythonKostenrechnerJev vs GPT
Konkrete Zahlen aus der Billing-Konfiguration dieser Site und den veröffentlichten TypeSafe-Spannen (siehe Benchmarks). Output-Tokens sind in der Abrechnung dieses Hosts kostenlos.
Latenzband
70–500 ms
Veröffentlichte System-One-Spanne (keine Chat-Latenz im Sekundenbereich)
Eingabe-Preis
≤ $0.42/M
Retail-Packs dieses Hosts; Output gratis
Kostenloser Test
5 Läufe
Anonyme Tool-Läufe gegen die echte API, ohne Registrierung
Monatliches Guthaben
10,000
Input-Tokens für angemeldete Konten
Starterpaket
$5
≈ 11.9 Mio. Input-Tokens
Workflow-Evals
~194× / ~445×
Veröffentlichte Speed-/Kosten-Rahmung gegenüber Chat-LLMs — Methodik