Visueller Bericht
Jev Geschwindigkeits- & Kosten-Benchmarks
Diagramme lesen
Das sind Community-Visualisierungen aus öffentlich diskutierten TypeSafe-Spannen und Workflow-Schlagzeilen. Keine unabhängigen Lab-Messungen von jevtypesafe.org. Nutze sie für Größenordnungen und verifiziere mit eigenen Fixtures über den API-Leitfaden.
- Latenz-Bänder sind entscheidend für Routing-Gates innerhalb einer Anfrage.
- Input-Preis + kostenlose Outputs zählen bei High-Volume-Scoring am meisten.
- Workflow-Multiplikatoren sind workload-abhängig; als obere Marketing-Band behandeln.
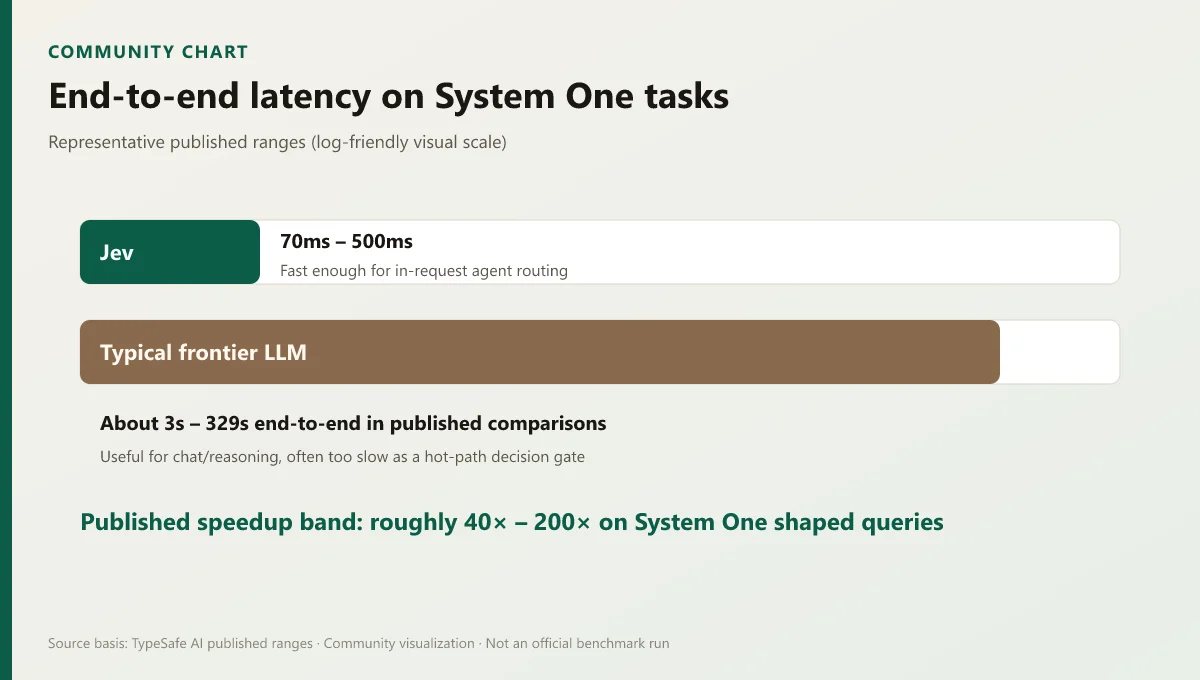
Latenz-Diagramm
Generative Frontier-Modelle können End-to-End Sekunden bis Minuten brauchen. Jevs veröffentlichtes System-One-Band liegt bei Zehnteln bis Hunderten Millisekunden — der Unterschied zwischen snappy Agent-Gate und blockierter Anfrage.
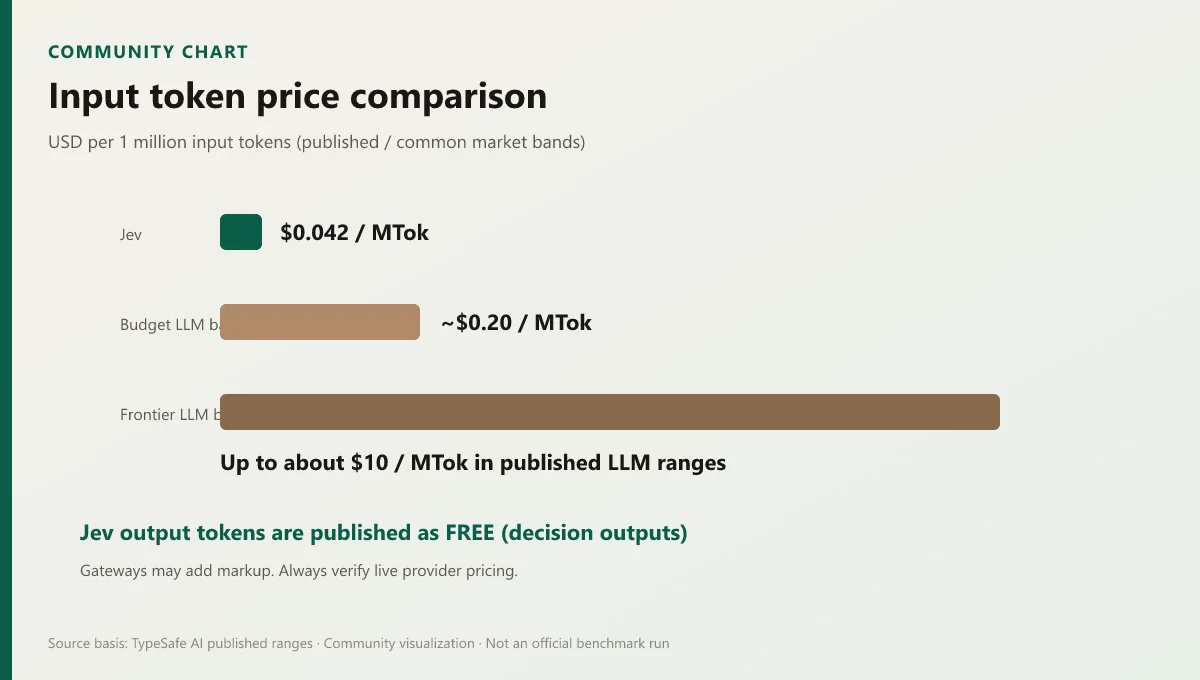
Preis-Diagramm
Jev listet etwa $0.042 / MTok für Input und kostenlose Output-Tokens. Übliche LLM-Bänder starten höher beim Input und berechnen weiterhin generierte Strings. Gateways können Aufschlag addieren — Live-Tarife vor Budgetierung prüfen.
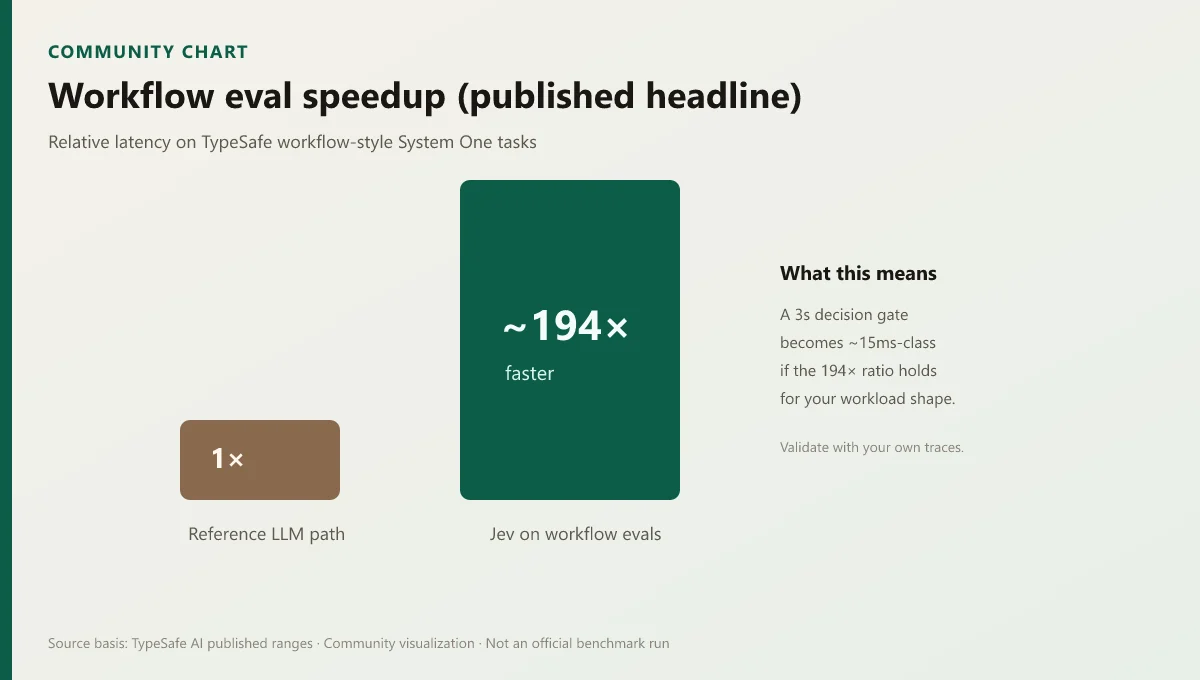
Workflow-Geschwindigkeit & Kosten-Schlagzeilen
TypeSafe Workflow-Evals veröffentlichten auffällige Relative-Zahlen gegenüber LLM-Entscheidungspfaden. Die folgenden Diagramme machen diese Schlagzeilen für Stakeholder scannbar, die das volle Eval nicht lesen.
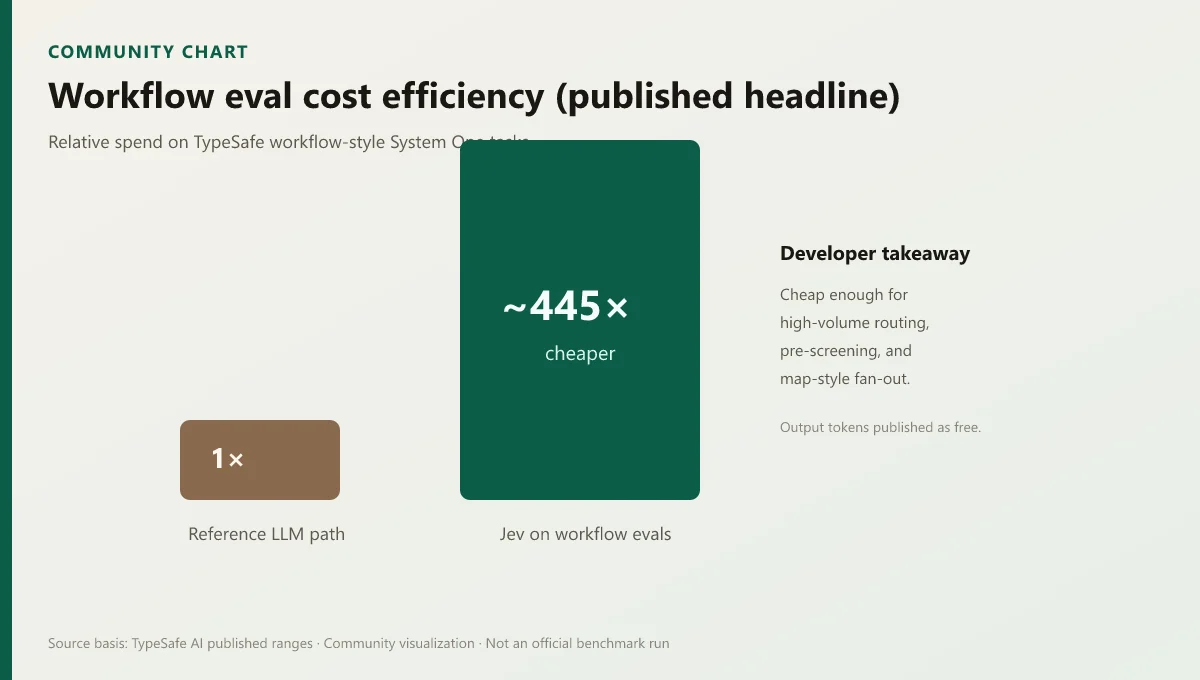
Öffentlichkeitsnahe Testszenarien
Diese Szenarien remixen Themen aus öffentlichen Demos und Developer-Artikeln (Routing-Desks, Batch-Entscheidungen, interaktive Loops, große Choice-Sets). Vorlagen für reproduzierbare Fixtures — keine kopierten offiziellen Lab-Notebooks.
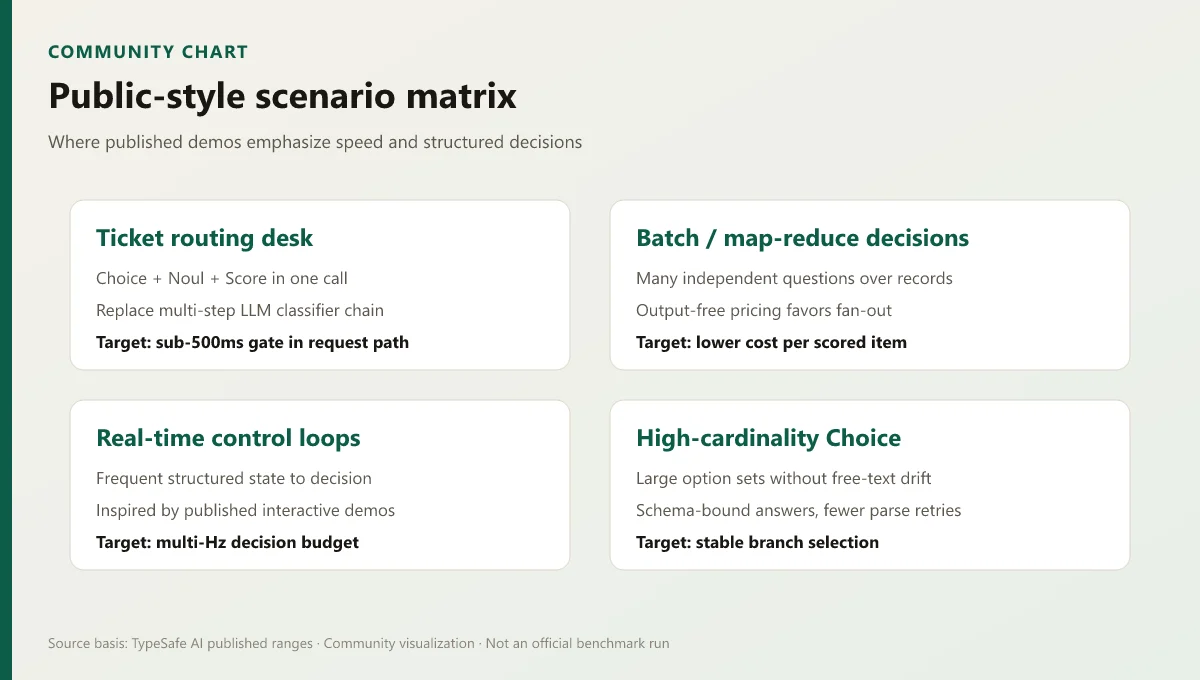
Support-Ticket-Triage-Desk
Eine Kundennachricht als State senden, dann Choice (Team), Noul (dringend?) und Score (Frustration) gemeinsam abfragen. Entspricht öffentlichen Routing-Demos und ersetzt eine Multi-Prompt-LLM-Klassifikator-Kette.
Sub-Sekunden-Entscheidungen erwarten, wenn das veröffentlichte Latenz-Band gilt.
Vorscreening vor teurem LLM-Reasoning
Jev filtert Niedrig-Risiko-Events; nur mehrdeutige Fälle zu GPT/Claude-Klasse eskalieren. Das Hybrid-Muster, das die Kostendiagramme in Produktion relevant macht.
Der Großteil des Volumens bleibt auf günstigen Entscheidungs-Calls; Spend konzentriert sich auf harte Fälle.
Batch-Map über Datensätze
Viele Zeilen mit demselben Fragen-Set scoren oder klassifizieren. Veröffentlichte kostenlose Output-Tokens machen spekulatives Fan-out deutlich weniger bestrafend als generative Modelle, die lange String-Antworten berechnen.
Kosten skalieren meist mit Input-Größe, nicht mit ausführlichen Antworten.
High-Cardinality-Choice-Auswahl
Große Optionsliste übergeben (Teams, SKUs, Wiki-Link-Choices). Schema-gebundene Antworten vermeiden Freitext-Halluzination und reduzieren Parser-Retries, die Latenz und Spend erhöhen.
Stabilitätsgewinne summieren sich mit wachsender Optionszahl.
Kosten-Faustformel-Tabelle
Grobe Community-Schätzung mit $0.042 / MTok Input und kostenlosen Outputs. Annahme ~1.000 Input-Tokens pro Entscheidungs-Call. Durch gemessene Token aus Traces ersetzen.
| Monatliche Entscheidungen | Ca. Input-Tokens | Gesch. Jev-Input-Spend |
|---|---|---|
| 100.000 | 100M | ~$4.20 |
| 1.000.000 | 1B | ~$42 |
| 10.000.000 | 10B | ~$420 |
Vergleiche mit generativen Klassifikatoren, die auch Output-Tokens berechnen und nach Parse-Fehlern oft Retries brauchen. Feature-Unterschiede siehe Jev vs. traditionelle LLMs.
Quellenangabe: